ノードタイプ browser_extractData
後続のステップで使用するために、テキストの一部を抽出します。
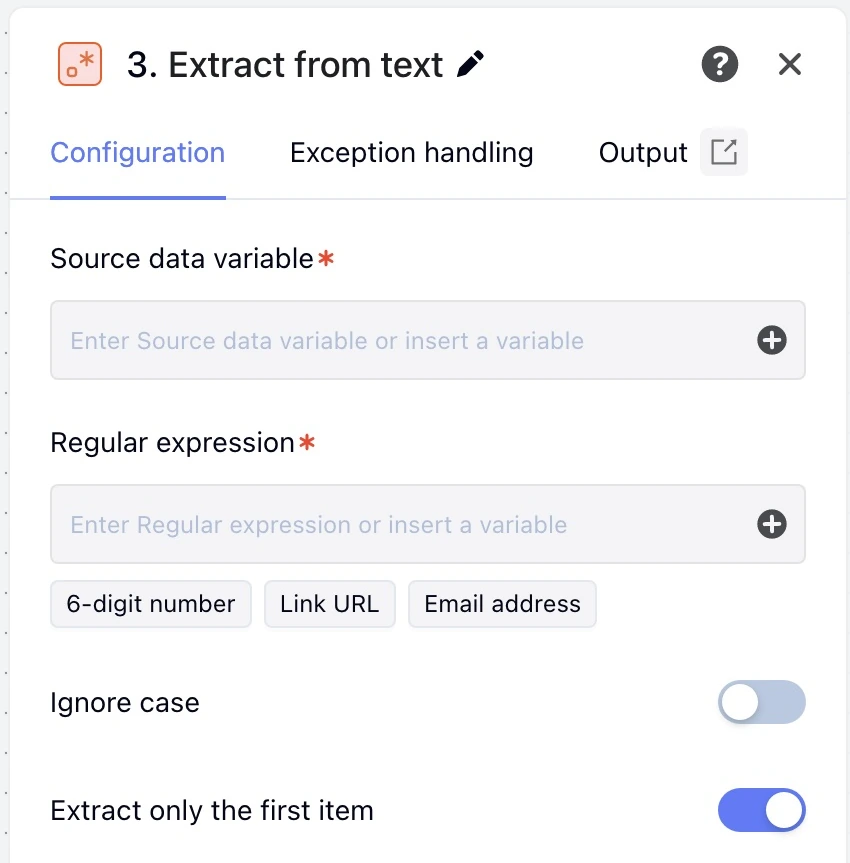
MoreLogin デスクトップクライアント V2.73.101 の英語インターフェースで撮影しました。
これらのフィールドは data.browserUi.inputs に置きます。
| フィールド | 型または値 | スキーマで必須 | 実行時の既定値 | 説明と制約 |
|---|---|---|---|---|
content | string | いいえ | — | ソースデータの変数 |
reg | string | いいえ | — | 正規表現 |
notUpper | boolean(変数参照をサポート) | いいえ | false | 大文字と小文字を区別しない。エディターの初期値:false |
onlyGetFirst | boolean(変数参照をサポート) | いいえ | true | 最初の項目のみ抽出。エディターの初期値:true |
- 必須:
reg - 正規表現の本体には、/…/ の区切り文字を含めません。
- 検証コード:
RPA_NODE_INPUT_INVALID - content は空でもかまいません。文字列以外の content(数値、真偽値、オブジェクト、配列)は、そのテキストまたは JSON テキストに対して照合されます。reg は、/…/ の区切り文字を含まない正規表現の本体です。
- 検証コード:
RPA_NODE_INPUT_INVALID
| フィールド | 許可される形式 |
|---|---|
content | literal, template |
reg | literal, template |
notUpper | literal, template |
onlyGetFirst | literal, template |
モード onlyGetFirst eq true
| 出力フィールド | 型または値 |
|---|---|
match | string / null |
matchCount | number |
モード onlyGetFirst eq false
| 出力フィールド | 型または値 |
|---|---|
matches | array<string> |
matchCount | number |
公開されているフィールドは、${nodeId.data.field} として参照します。
ワークフローの nodes 配列、または別のノードの blocks に入れる完全なノードオブジェクトです。前にある「要素データを読み取る」ノードの出力 read_title.data.text を読み取ります。
{
  "id": "order_number",
  "type": "browser_extractData",
  "data": {
    "title": "Extract the order number",
    "browserAction": "extractData",
    "browserUi": {
      "inputs": {
        "content": "${read_title.data.text}",
        "reg": "#(\\d+)",
        "notUpper": false,
        "onlyGetFirst": true
      },
      "exception": {
        "timeout": 30000,
        "policy": "interrupt"
      }
    }
  }
}